Στη γραμμική παλινδρόμηση, η γνώση της αναμενόμενης τιμής και του variance ενός εκτιμημένου συντελεστή είναι απαραίτητη για την κατανόηση των βασικών ιδιοτήτων της αμεροληψίας και της αποτελεσματικότητας. Ωστόσο, η γνώση της αναμενόμενης τιμής και του variance της δειγματοληπτικής κατανομής ενός εκτιμημένου συντελεστή δεν μας λέει τίποτα για τη μορφή της κατανομής· θα μπορούσε να είναι κανονική, ομοιόμορφη ή οποιασδήποτε άλλης μορφής.
Αυτό σημαίνει ότι η αναμενόμενη τιμή και το variance δεν αρκούν από μόνα τους για τη στατιστική συμπερασματολογία—δηλαδή για την εξαγωγή συμπερασμάτων για τον πληθυσμό από τα δεδομένα του δείγματος. Όπως συζητήσαμε στο Κεφάλαιο Έλεγχος υποθέσεων, η στατιστική συμπερασματολογία βασίζεται σε θεωρητικές κατανομές πιθανοτήτων για να ποσοτικοποιήσει την αβεβαιότητα και να αξιολογήσει πόσο εύλογες είναι διάφορες υποθέσεις.
Η κατανομή που χρησιμοποιούμε για τη συμπερασματολογία εξαρτάται από το πλαίσιο. Θα μπορούσε να είναι μια κανονική κατανομή, μια κατανομή t ή κάποια εντελώς διαφορετική κατανομή. Στη γραμμική παλινδρόμηση, η στατιστική συμπερασματολογία βασίζεται στη δειγματοληπτική κατανομή των εκτιμημένων συντελεστών. Υπό τις τυπικές υποθέσεις, τα αντίστοιχα στατιστικά t ακολουθούν κατανομή t, κάτι που μας επιτρέπει να κατασκευάσουμε διαστήματα εμπιστοσύνης και να εκτελέσουμε ελέγχους υποθέσεων.
Σε αυτό το κεφάλαιο, εξετάζουμε πώς η γραμμική παλινδρόμηση μπορεί να χρησιμοποιηθεί όχι μόνο για την εκτίμηση σχέσεων αλλά και για τυπική στατιστική συμπερασματολογία. Βασιζόμαστε στις έννοιες που αναπτύξαμε σε προηγούμενα κεφάλαια, όπως οι δειγματοληπτικές κατανομές, τα standard errors, ο έλεγχος υποθέσεων και τα διαστήματα εμπιστοσύνης. Υπό αυτή την έννοια, δεν υπάρχει τίποτα εντελώς καινούργιο εδώ—αντίθετα, συνδυάζουμε αρκετές γνώριμες ιδέες και τις εφαρμόζουμε στο πλαίσιο της παλινδρόμησης. Θα εστιάσουμε στο πώς ελέγχουμε αν ένας συντελεστής διαφέρει σημαντικά από το μηδέν και στο πώς κατασκευάζουμε διαστήματα εμπιστοσύνης για τους εκτιμημένους συντελεστές.
Παρουσιάζουμε επίσης μερικές χρήσιμες συναρτήσεις της R που κάνουν αυτές τις εργασίες απλές στην πράξη. Σε αυτό το κεφάλαιο η θεωρία συναντά την εφαρμογή: χρησιμοποιούμε πλέον την παλινδρόμηση όχι μόνο ως εργαλείο μοντελοποίησης, αλλά και ως πλαίσιο συλλογισμού υπό αβεβαιότητα.
Από την εκτίμηση στον έλεγχο υποθέσεων
Ας επιστρέψουμε τώρα στο μοντέλο πολλαπλής γραμμικής παλινδρόμησης. Ξεκινάμε φορτώνοντας το πακέτο tidyverse, εισάγοντας το σύνολο δεδομένων από το GitHub και κάνοντας παλινδρόμηση του Revenue στα Ad_Spend, Product_Quality_Score και Website_Visitors:
# Βιβλιοθήκεςlibrary(tidyverse)# Εισαγωγή του eshop_revenueseshop_revenues <-read_csv("https://raw.githubusercontent.com/Datakortex/Datasets/refs/heads/main/eshop_revenues.csv")# Προσαρμογή μοντέλου γραμμικής παλινδρόμησηςlm_model <-lm(Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors,data = eshop_revenues)# Εμφάνιση των συντελεστώνprint(lm_model)
Αυτό το μοντέλο μάς δίνει εκτιμημένους συντελεστές για κάθε ανεξάρτητη μεταβλητή. Με βάση αυτό το αποτέλεσμα, η εκτιμημένη εξίσωση παλινδρόμησης είναι:
Τώρα που έχουμε τις εκτιμήσεις των συντελεστών, μπορούμε να ερμηνεύσουμε την αναμενόμενη μεταβολή των εσόδων που σχετίζεται με κάθε ανεξάρτητη μεταβλητή. Παραμένει όμως ένα σημαντικό ερώτημα: είναι αυτές οι επιδράσεις στατιστικά σημαντικές; Για παράδειγμα, αν ο συντελεστής του Website_Visitors ήταν 0.001, θα σήμαινε ότι, κρατώντας τις άλλες μεταβλητές σταθερές, τα έσοδα αναμένεται να αυξηθούν μόνο κατά €1 για κάθε 1,000 επιπλέον επισκέπτες. Μια τέτοια επίδραση μπορεί να είναι αμελητέα στην πράξη. Χρειαζόμαστε τη στατιστική συμπερασματολογία για να διαπιστώσουμε αν μια τέτοια επίδραση διακρίνεται από το μηδέν στον πληθυσμό ή αν θα μπορούσε απλώς να είναι αποτέλεσμα της τυχαίας δειγματοληπτικής διακύμανσης.
Όπως συζητήσαμε στο Κεφάλαιο Έλεγχος υποθέσεων, πρέπει να διατυπώσουμε μια μηδενική υπόθεση και μια εναλλακτική υπόθεση για να καθοδηγήσουμε τη συμπερασματολογία μας. Στην ανάλυση παλινδρόμησης, συνήθως ελέγχουμε αν κάθε συντελεστής διαφέρει σημαντικά από το μηδέν. Για παράδειγμα, οι υποθέσεις για τον συντελεστή του Ad_Spend θα μπορούσαν να είναι:
\(H_0: \beta_1 = 0\)
\(H_1: \beta_1 \ne 0\)
Για να αξιολογήσουμε αυτές τις υποθέσεις, εκτελούμε ένα t-test για κάθε συντελεστή. Ο τύπος για το στατιστικό t είναι:
Εδώ, το \(\hat{\beta}_{j}\) είναι ο εκτιμημένος συντελεστής, το \(\beta_{j}\) είναι η υποτιθέμενη τιμή υπό τη μηδενική υπόθεση (συνήθως 0) και το \(SE(\hat{\beta}_{j})\) είναι το standard error της εκτίμησης. Όπως είδαμε σε προηγούμενα κεφάλαια, το standard error προκύπτει από το variance των καταλοίπων του μοντέλου και δείχνει πόσο θα διέφερε η εκτίμηση σε επαναλαμβανόμενα δείγματα.
Αφού υπολογίσουμε την τιμή t, τη συγκρίνουμε με την κατανομή t με τους κατάλληλους βαθμούς ελευθερίας (\(n - k - 1\)), για να διαπιστώσουμε αν η παρατηρούμενη τιμή είναι αρκετά ακραία ώστε να απορρίψουμε τη μηδενική υπόθεση. Όλες οι έννοιες που εισαγάγαμε νωρίτερα στον έλεγχο υποθέσεων—όπως οι κρίσιμες τιμές, τα p-values και τα διαστήματα εμπιστοσύνης—ισχύουν και εδώ.
Οι συντελεστές, τα standard errors, οι τιμές t και τα αντίστοιχα p-values υπολογίζονται όλα αυτόματα όταν χρησιμοποιούμε τη συνάρτηση lm() στην R. Για να τα προσπελάσουμε και να τα εμφανίσουμε, χρησιμοποιούμε τη συνάρτηση summary() στο object του μοντέλου. Αυτή η σύνοψη παρέχει μια πλήρη εικόνα των εκτιμημένων συντελεστών, της μεταβλητότητάς τους από δείγμα σε δείγμα, των αποτελεσμάτων των ελέγχων υποθέσεων (μέσω των τιμών t) και των αντίστοιχων p-values, που δείχνουν αν κάθε συντελεστής είναι στατιστικά σημαντικός.
# Εμφάνιση του αναλυτικού αποτελέσματος της παλινδρόμησηςlm_model %>%summary()
Call:
lm(formula = Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors,
    data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-37767  -6250   -745   3936  46169

Coefficients:
                        Estimate Std. Error t value Pr(>|t|)
(Intercept)           -35222.037   5749.350  -6.126 1.06e-08 ***
Ad_Spend                  48.888      5.914   8.267 1.64e-13 ***
Product_Quality_Score   5030.115    784.281   6.414 2.60e-09 ***
Website_Visitors           7.791      3.944   1.975   0.0504 .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 10510 on 126 degrees of freedom
Multiple R-squared:  0.5849,    Adjusted R-squared:  0.575
F-statistic: 59.17 on 3 and 126 DF,  p-value: < 2.2e-16
Αυτό το αποτέλεσμα περιέχει αρκετά σημαντικά στοιχεία που μας επιτρέπουν να κάνουμε στατιστική συμπερασματολογία.
Ας δούμε τα βασικά μέρη του:
Call: Η πρώτη γραμμή εμφανίζει τον τύπο που χρησιμοποιήθηκε για τον ορισμό του μοντέλου. Αυτό βοηθά να επιβεβαιώσουμε ότι κάναμε παλινδρόμηση της σωστής εξαρτημένης μεταβλητής στις κατάλληλες προβλεπτικές μεταβλητές.
Residuals: Αυτή η ενότητα συνοψίζει την κατανομή των καταλοίπων—δηλαδή των διαφορών μεταξύ των παρατηρούμενων και των προβλεπόμενων τιμών της εξαρτημένης μεταβλητής. Αναφέρει πέντε συνοπτικά στατιστικά: την ελάχιστη τιμή, το 1ο τεταρτημόριο, το median, το 3ο τεταρτημόριο και τη μέγιστη τιμή. Ιδανικά, τα κατάλοιπα θα πρέπει να κατανέμονται συμμετρικά γύρω από το μηδέν, κάτι που θα στήριζε την υπόθεση ότι τα σφάλματα έχουν μηδενικό mean.
Coefficients: Αυτός είναι ο βασικός πίνακας για τη συμπερασματολογία. Κάθε γραμμή αντιστοιχεί σε μια παράμετρο του μοντέλου (σταθερός όρος ή κλίση), και κάθε στήλη δίνει σημαντική πληροφορία.
Estimate: Η εκτιμημένη τιμή του συντελεστή \(\hat{\beta}_{j}\).
Std. Error: Το standard error της εκτίμησης, που αντανακλά τη μεταβλητότητά της σε επαναλαμβανόμενα δείγματα.
t value: Το στατιστικό ελέγχου που χρησιμοποιείται για να αξιολογήσουμε αν ένας συντελεστής διαφέρει σημαντικά από το μηδέν. Υπολογίζεται ως:
όπου η δεύτερη ισότητα προκύπτει από τη μηδενική υπόθεση \(H_0: \beta_j = 0\). Όσο μεγαλύτερη είναι η απόλυτη τιμή του στατιστικού t, τόσο ισχυρότερες είναι οι ενδείξεις εναντίον της μηδενικής υπόθεσης.
Pr(>|t|): Το p-value που συνδέεται με το t-test. Ένα μικρό p-value (συνήθως κάτω από 0.05) αποτελεί ένδειξη εναντίον της μηδενικής υπόθεσης, υποδεικνύοντας ότι ο συντελεστής είναι στατιστικά σημαντικός.
Ο πίνακας μπορεί επίσης να περιλαμβάνει σύμβολα όπως * ή ** για να δηλώσει τα επίπεδα σημαντικότητας, συνήθως με βάση τα συμβατικά όρια (π.χ. 0.1, 0.05, 0.01). Αυτές οι οπτικές υποδείξεις βοηθούν να εντοπίσουμε γρήγορα ποιες προβλεπτικές μεταβλητές είναι στατιστικά σημαντικές.
Residual standard error: Αυτή είναι μια εκτίμηση του standard deviation (\(\sqrt{\sigma^2}\)) του όρου σφάλματος.
Degrees of freedom: Μας δείχνει πόσες παρατηρήσεις και πόσες προβλεπτικές μεταβλητές χρησιμοποιήθηκαν, κάτι που καθορίζει το σχήμα της κατανομής t που χρησιμοποιείται στους ελέγχους υποθέσεων.
R-squared και adjusted R-squared: Αυτές οι τιμές συνοψίζουν πόσο καλά εξηγεί το μοντέλο τη μεταβλητότητα της εξαρτημένης μεταβλητής. Το R-squared δίνει το ποσοστό του variance που εξηγείται από το μοντέλο, ενώ η προσαρμοσμένη εκδοχή λαμβάνει υπόψη τον αριθμό των προβλεπτικών μεταβλητών, «τιμωρώντας» την περιττή πολυπλοκότητα.
Θα επιστρέψουμε στα βασικά στατιστικά του μοντέλου που αφορούν το στατιστικό F και το p-value του αργότερα σε αυτό το κεφάλαιο, όταν θα συζητήσουμε πώς αξιολογούμε τη συνολική σημαντικότητα ενός μοντέλου παλινδρόμησης.
Όσον αφορά το αποτέλεσμα του παραδείγματός μας, σχεδόν όλοι οι συντελεστές είναι στατιστικά σημαντικοί σε επίπεδο σημαντικότητας 5%, κάτι που δείχνει ότι αυτές οι προβλεπτικές μεταβλητές έχουν ουσιαστική σχέση με την εξαρτημένη μεταβλητή. Μια οριακή περίπτωση είναι ο συντελεστής του Website_Visitors, με p-value 0.0504, ελαφρώς πάνω από το συνηθισμένο όριο του 5%. Παρόλο που τεχνικά δεν ικανοποιεί το όριο σημαντικότητας, είναι εξαιρετικά κοντά, και τέτοιες μικρές διαφορές συνήθως αντιμετωπίζονται με προσοχή και ερμηνεύονται με βάση το πλαίσιο και όχι άκαμπτα.
Οι τιμές του R-squared και του adjusted R-squared είναι 58.49% και 57.50% αντίστοιχα. Το adjusted R-squared «τιμωρεί» τη συμπερίληψη επιπλέον μεταβλητών που δεν βελτιώνουν αρκετά το μοντέλο. Εδώ οι δύο τιμές είναι κοντά κυρίως επειδή ο αριθμός των προβλεπτικών μεταβλητών (3) είναι μικρός σε σχέση με τον αριθμό των παρατηρήσεων (130), οπότε η «ποινή» είναι μικρή. Μια μικρή διαφορά, επομένως, δεν αποτελεί από μόνη της απόδειξη ότι κάθε μεταβλητή συμβάλλει ουσιαστικά· για αυτό χρησιμοποιούμε τους μεμονωμένους και τους κοινούς ελέγχους που συζητάμε σε αυτό το κεφάλαιο.
Υπόθεση της στατιστικής συμπερασματολογίας
Όπως αναφέραμε νωρίτερα, η γνώση της αναμενόμενης τιμής και του variance ενός εκτιμημένου συντελεστή είναι χρήσιμη για την κατανόηση της αμεροληψίας και της αποτελεσματικότητας. Ωστόσο, δεν αρκεί για τη στατιστική συμπερασματολογία. Για να εκτελέσουμε ελέγχους υποθέσεων, όπως το t-test, βασιζόμαστε σε θεωρητικές κατανομές. Αυτό εισάγει μία επιπλέον υπόθεση που απαιτείται για τη συμπερασματολογία στο κλασικό μοντέλο γραμμικής παλινδρόμησης: την υπόθεση κανονικότητας (normality assumption), σύμφωνα με την οποία οι όροι σφάλματος του μοντέλου παλινδρόμησης είναι ανεξάρτητοι από τις ανεξάρτητες μεταβλητές και κατανέμονται κανονικά με μέση τιμή μηδέν και σταθερό variance. Μαθηματικά, αυτό γράφεται ως:
\[u \sim N(0, \sigma^2)\]
Έχουμε ήδη υποθέσει ότι οι όροι σφάλματος έχουν αναμενόμενη τιμή μηδέν (δηλαδή είναι κεντραρισμένοι γύρω από το μηδέν) και ότι όλοι έχουν το ίδιο σταθερό variance, \(\sigma^2\). Η υπόθεση κανονικότητας προσθέτει ότι η μορφή της κατανομής είναι επίσης γνωστή: είναι κωδωνοειδής, συμμετρική και ακολουθεί την κανονική (Γκαουσιανή) κατανομή.
Αυτή η υπόθεση μεταφέρεται και στην κατανομή της εξαρτημένης μεταβλητής \(y\), δεδομένων των τιμών των ανεξάρτητων μεταβλητών \(\mathbf{X}\). Με άλλα λόγια:
Αυτό σημαίνει ότι για οποιοδήποτε σταθερό σημείο στον πολυδιάστατο χώρο των ανεξάρτητων μεταβλητών, η τιμή του \(y\) κατανέμεται κανονικά γύρω από τη δεσμευμένη μέση τιμή της. Δηλαδή, κρατώντας σταθερές τις ανεξάρτητες μεταβλητές, το \(y\) συμπεριφέρεται ως κανονική τυχαία μεταβλητή.
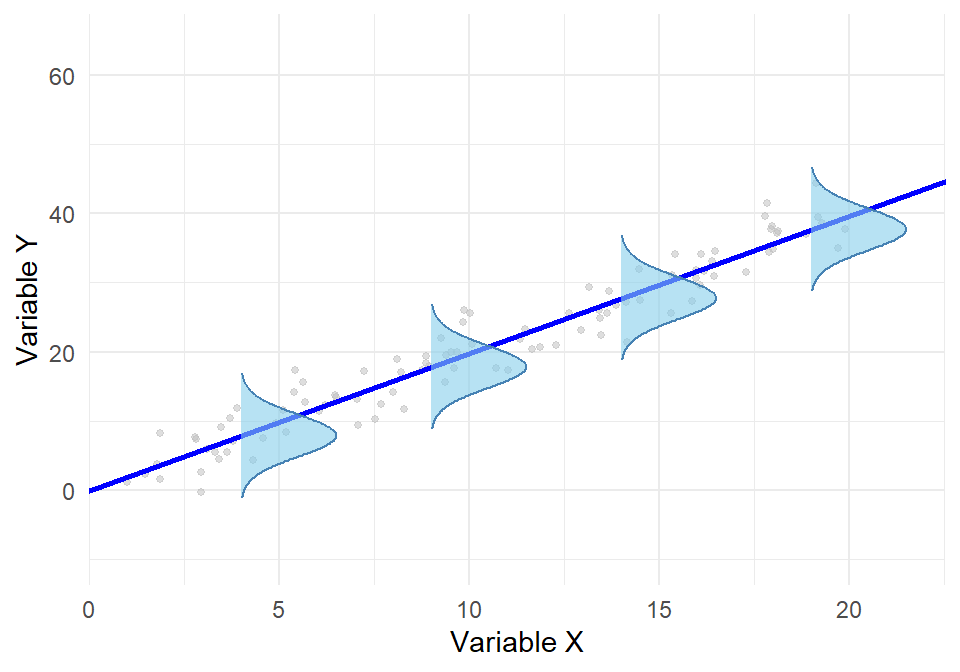
Το παρακάτω διάγραμμα απεικονίζει αυτή την υπόθεση: η μεταβλητή απόκρισης \(y\) ακολουθεί κανονική κατανομή γύρω από την ευθεία παλινδρόμησης σε κάθε τιμή του \(x\). Σε αρκετές τιμές του \(x\), σχεδιάζουμε την κανονική κατανομή του \(y\), κεντραρισμένη στην προβλεπόμενη τιμή του \(y\) πάνω στην (μπλε) ευθεία παλινδρόμησης, ενώ τα γκρι σημεία είναι προσομοιωμένες παρατηρήσεις. Αυτό αναδεικνύει την υπόθεση κανονικότητας των σφαλμάτων—ότι η μεταβλητότητα του \(y\) σε κάθε επίπεδο του \(x\) είναι τυχαία και κανονικά κατανεμημένη. Αφού όλες οι καμπύλες έχουν την ίδια διασπορά, το διάγραμμα δείχνει επίσης ομοσκεδαστικότητα. Αν ισχύουν αυτές οι υποθέσεις και η σχέση μεταξύ \(x\) και \(y\) είναι πράγματι γραμμική, τότε η μπλε ευθεία παλινδρόμησης αντιπροσωπεύει την καλύτερη δυνατή γραμμική εκτίμηση της αναμενόμενης τιμής του \(y\) δεδομένου του \(x\). Με άλλα λόγια, υπό αυτές τις συνθήκες, δεν υπάρχει καλύτερη ευθεία που θα μπορούσαμε να σχεδιάσουμε για να αποτυπώσουμε τη μέση συμπεριφορά του \(y\) στις διάφορες τιμές του \(x\).
Εικόνα 25.1: Κανονικά σφάλματα με σταθερό variance (ομοσκεδαστικότητα).
Επειδή οι εκτιμήσεις OLS είναι γραμμικοί συνδυασμοί της εξαρτημένης μεταβλητής \(y\), και το \(y\) κατανέμεται κανονικά, προκύπτει ότι και οι ίδιοι οι εκτιμημένοι συντελεστές κατανέμονται κανονικά:
Γενικότερα, οποιοσδήποτε γραμμικός συνδυασμός των εκτιμημένων συντελεστών, όπως ο \(c_1 \hat{\beta}_1 + c_2 \hat{\beta}_2\), κατανέμεται επίσης κανονικά. Αυτή η ιδιότητα μας επιτρέπει να κατασκευάζουμε διαστήματα εμπιστοσύνης και να εκτελούμε ελέγχους υποθέσεων τόσο για μεμονωμένους συντελεστές όσο και για συνδυασμούς τους.
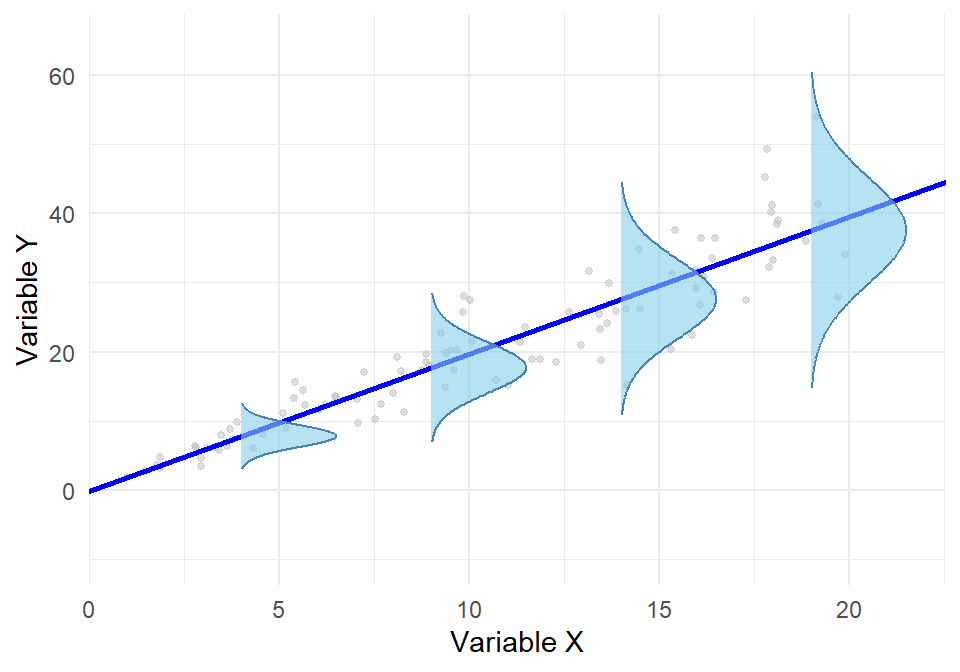
Το παρακάτω διάγραμμα δείχνει μια περίπτωση όπου τα σφάλματα εξακολουθούν να κατανέμονται κανονικά, αλλά το variance τους δεν είναι σταθερό:
Εικόνα 25.2: Κανονικά σφάλματα με αυξανόμενο variance (ετεροσκεδαστικότητα).
Η ευθεία παλινδρόμησης εξακολουθεί να περιγράφει καλά τη μέση σχέση, αλλά η διασπορά των σημείων γύρω από την ευθεία δεν είναι ίδια παντού—τα σημεία βρίσκονται κοντά στην ευθεία για μικρές τιμές του \(x\) και είναι πολύ πιο διασκορπισμένα για μεγάλες τιμές. Οι εκτιμήσεις OLS παραμένουν αμερόληπτες, αλλά τα συνηθισμένα standard errors, τα οποία υποθέτουν ένα ενιαίο κοινό variance \(\sigma^2\), δεν είναι πλέον σωστά. Κατά συνέπεια, τα t-tests και τα διαστήματα εμπιστοσύνης που χρησιμοποιούμε για να αποφασίσουμε αν η κλίση διαφέρει σημαντικά από το 0 μπορεί να είναι παραπλανητικά.
Το παραπάνω διάγραμμα δείχνει επίσης ότι είναι δυνατό να έχουμε κανονικές κατανομές με διαφορετικά variances γύρω από την ευθεία παλινδρόμησης. Σε αυτή την περίπτωση, τα σφάλματα εξακολουθούν να είναι κεντραρισμένα γύρω από το μηδέν σε κάθε τιμή του x, αλλά η διασπορά της κατανομής αλλάζει ανάλογα με το \(x\) (εδώ, αυξάνεται με το \(x\)). Αυτό είναι ένα παράδειγμα ετεροσκεδαστικότητας με δεσμευμένη κανονικότητα (heteroskedasticity with conditional normality). Σε μια τέτοια περίπτωση, τα σφάλματα μπορεί να εξακολουθούν να κατανέμονται κανονικά σε κάθε τιμή του \(x\), αλλά παραβιάζεται η υπόθεση του σταθερού variance, που σημαίνει ότι η ακρίβεια των εκτιμήσεών μας διαφέρει στις διάφορες τιμές της ανεξάρτητης μεταβλητής.
Επομένως, για να είναι έγκυρη η τυπική συμπερασματολογία του OLS (συμπεριλαμβανομένων των ελέγχων υποθέσεων και των διαστημάτων εμπιστοσύνης), βασιζόμαστε στις πέντε κλασικές υποθέσεις που συζητήσαμε σε προηγούμενα κεφάλαια:
Γραμμικότητα ως προς τις παραμέτρους
Τυχαία και ανεξάρτητη δειγματοληψία
Μεταβλητότητα στο δείγμα και απουσία τέλειας πολυσυγγραμμικότητας
Μηδενική δεσμευμένη αναμενόμενη τιμή των σφαλμάτων
Ομοσκεδαστικότητα (σταθερό variance των σφαλμάτων)
Προσθέτοντας την κανονικότητα των όρων σφάλματος, έχουμε πλέον μια έκτη υπόθεση. Μαζί, αυτές οι έξι υποθέσεις ορίζουν αυτό που είναι γνωστό ως Κλασικό Γραμμικό Μοντέλο (Classical Linear Model, CLM). Υπό αυτές τις υποθέσεις, οι εκτιμητές OLS σε δεδομένα διαστρωματικής μορφής (cross-sectional) δεν είναι μόνο BLUE (βέλτιστοι γραμμικοί αμερόληπτοι εκτιμητές, όπως ορίζει το θεώρημα Gauss-Markov), αλλά και κανονικά κατανεμημένοι, κάτι που μας επιτρέπει να κάνουμε έγκυρη στατιστική συμπερασματολογία με t-tests και F-tests (Wooldridge, 2020).
Παραδόξως, ακόμη και αν παραβιάζεται η υπόθεση κανονικότητας, η στατιστική συμπερασματολογία μπορεί να εξακολουθεί να είναι έγκυρη όταν το μέγεθος του δείγματος είναι αρκετά μεγάλο. Αυτό οφείλεται στο κεντρικό οριακό θεώρημα (Central Limit Theorem, CLT). Το CLT ορίζει ότι, υπό ορισμένες συνθήκες κανονικότητας (regularity conditions), η κατανομή του δειγματικού mean (και, γενικότερα, γραμμικών εκτιμητών όπως το OLS) προσεγγίζει την κανονική κατανομή καθώς αυξάνεται το μέγεθος του δείγματος. Αυτό σημαίνει ότι, σε μεγάλα δείγματα, οι εκτιμημένοι συντελεστές θα εξακολουθούν να κατανέμονται κατά προσέγγιση κανονικά, ακόμη και αν οι αρχικοί όροι σφάλματος δεν είναι κανονικοί. Κατά συνέπεια, τα συνηθισμένα t-tests και διαστήματα εμπιστοσύνης γίνονται ασυμπτωτικά έγκυρα (Wooldridge, 2020).
Ο όρος ασυμπτωτικά (asymptotically) αναφέρεται σε αυτό που συμβαίνει καθώς το μέγεθος του δείγματος τείνει στο άπειρο. Με άλλα λόγια, οι ασυμπτωτικές ιδιότητες περιγράφουν τη συμπεριφορά των εκτιμητών όταν φανταζόμαστε ότι έχουμε όλο και περισσότερα δεδομένα. Ένας εκτιμητής λέγεται ασυμπτωτικά κανονικός (asymptotically normal) αν η κατανομή του πλησιάζει όλο και περισσότερο την κανονική κατανομή καθώς αυξάνεται το μέγεθος του δείγματος. Ομοίως, ένας έλεγχος είναι ασυμπτωτικά έγκυρος (asymptotically valid) αν τα συμπεράσματά του (π.χ. η απόρριψη ή μη απόρριψη της μηδενικής υπόθεσης) γίνονται όλο και πιο ακριβή και αξιόπιστα με περισσότερα δεδομένα.
Είναι σημαντικό να σημειώσουμε ότι τα ασυμπτωτικά αποτελέσματα δεν είναι ακριβή σε πεπερασμένα δείγματα (finite samples). Είναι προσεγγίσεις που βελτιώνονται όσο μεγαλώνει το δείγμα. Επομένως, σε μικρά σύνολα δεδομένων, προτιμούμε να υποθέτουμε ρητά την κανονικότητα αν θέλουμε να χρησιμοποιήσουμε t-tests ή να κατασκευάσουμε διαστήματα εμπιστοσύνης.
Η έννοια της ασυμπτωτικής εγκυρότητας μπορεί να φαίνεται αφηρημένη και είναι κυρίως θεωρητική. Μας βοηθά να κατανοήσουμε τη μακροπρόθεσμη συμπεριφορά των εκτιμητών και των στατιστικών ελέγχων υπό γενικές συνθήκες. Στην πράξη, δεν παρατηρούμε ποτέ ένα άπειρο δείγμα—επομένως αυτά τα αποτελέσματα καθοδηγούν τις προσδοκίες μας και δικαιολογούν τη χρήση ορισμένων μεθόδων σε μεγάλα δείγματα, αντί να αποτελούν εγγύηση σε κάθε περίπτωση.
Συμπερασματικά, η κανονικότητα είναι καθοριστική για την εξαγωγή ακριβών συμπερασμάτων σε μικρά δείγματα. Μας επιτρέπει να χρησιμοποιήσουμε την κατανομή t για να κατασκευάσουμε διαστήματα εμπιστοσύνης και να εκτελέσουμε ελέγχους υποθέσεων για τους συντελεστές παλινδρόμησης. Ωστόσο, σε μεγάλα δείγματα, ακόμη και αν οι όροι σφάλματος δεν είναι απόλυτα κανονικοί, το κεντρικό οριακό θεώρημα βοηθά ώστε οι εκτιμήσεις μας και οι στατιστικοί έλεγχοι να παραμένουν κατά προσέγγιση έγκυροι. Έτσι, η κανονικότητα είναι μια χρήσιμη αλλά όχι πάντα απαραίτητη υπόθεση—η σημασία της εξαρτάται από το μέγεθος του δείγματος.
Το F-test στη γραμμική παλινδρόμηση
Στο Κεφάλαιο Κατανομές χι-τετράγωνο και F, συζητήσαμε πώς μπορεί να χρησιμοποιηθεί το F-test για να συγκρίνουμε δύο variances και να διαπιστώσουμε αν διαφέρουν σημαντικά. Στο πλαίσιο της γραμμικής παλινδρόμησης, το F-test εξυπηρετεί έναν συναφή σκοπό: αξιολογεί αν το μοντέλο στο σύνολό του προσαρμόζεται στα δεδομένα σημαντικά καλύτερα από ένα μοντέλο χωρίς καμία προβλεπτική μεταβλητή.
Θυμηθείτε ότι ο στόχος της παλινδρόμησης είναι να εξηγήσει τη μεταβλητότητα της εξαρτημένης μεταβλητής \(y\) με τη βοήθεια των ανεξάρτητων μεταβλητών. Όταν εκτελούμε μια παλινδρόμηση, ουσιαστικά αναλύουμε τη συνολική μεταβλητότητα του \(y\)—το συνολικό άθροισμα τετραγώνων (Total Sum of Squares, TSS)—σε δύο μέρη:
Το μέρος που εξηγείται από την παλινδρόμηση: το ερμηνευόμενο άθροισμα τετραγώνων (Explained Sum of Squares, ESS)
Το μέρος που δεν εξηγείται: το άθροισμα τετραγώνων των καταλοίπων (Residual Sum of Squares, RSS).
Μαθηματικά:
\[\text{TSS} = \text{ESS} + \text{RSS}\]
Το RSS αποτυπώνει το ανεξήγητο variance—τις διαφορές μεταξύ των παρατηρούμενων τιμών και των τιμών που προβλέπει το μοντέλο μας. Αν το μοντέλο έχει μικρή ερμηνευτική ικανότητα, το RSS θα είναι κοντά στο TSS. Αν το μοντέλο εξηγεί ένα σημαντικό μέρος του variance, το RSS θα είναι σχετικά μικρό και το ESS θα είναι μεγάλο.
Το στατιστικό F (F-statistic) είναι ένας λόγος που συγκρίνει το variance που εξηγείται από το μοντέλο με αυτό που μένει ανεξήγητο, προσαρμοσμένο για τον αριθμό των προβλεπτικών μεταβλητών και τον αριθμό των παρατηρήσεων. Υπολογίζεται ως εξής:
\(k\) είναι ο αριθμός των προβλεπτικών μεταβλητών (χωρίς τον σταθερό όρο)
\(n\) είναι ο αριθμός των παρατηρήσεων
Αυτός ο τύπος συγκρίνει το ερμηνευόμενο variance ανά προβλεπτική μεταβλητή με το ανεξήγητο variance ανά βαθμό ελευθερίας των καταλοίπων. Μια υψηλή τιμή F υποδηλώνει ότι το μοντέλο εξηγεί ένα σημαντικό μέρος του variance του \(y\), σε σχέση με αυτό που μένει ανεξήγητο.
Μπορούμε να υπολογίσουμε το στατιστικό F χειροκίνητα στην R με τον παρακάτω κώδικα:
# Πραγματικές τιμέςy <- eshop_revenues$Revenue# Προβλεπόμενες τιμέςy_hat <- lm_model$fitted.values# Mean του yy_bar <-mean(y)# Συνολικό άθροισμα τετραγώνωνTSS <-sum((y - y_bar)^2)# Άθροισμα τετραγώνων που εξηγείται (Explained Sum of Squares)ESS <-sum((y_hat - y_bar)^2)# Άθροισμα τετραγώνων των καταλοίπωνRSS <-sum((y - y_hat)^2)# Αριθμός προβλεπτικών μεταβλητώνk <-3# Μέγεθος δείγματοςn <-130# Τύπος του στατιστικού FF_stat <- (ESS / k) / (RSS / (n - k -1))# Εμφάνιση του στατιστικού FF_stat
[1] 59.16957
Έτσι παίρνουμε το ίδιο στατιστικό F με αυτό που εμφανίζεται στο κάτω μέρος του αποτελέσματος της παλινδρόμησης όταν χρησιμοποιούμε τη συνάρτηση summary():
# Εμφάνιση του αναλυτικού αποτελέσματος της παλινδρόμησηςlm_model %>%summary()
Call:
lm(formula = Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors,
    data = eshop_revenues)

Residuals:
   Min     1Q Median     3Q    Max
-37767  -6250   -745   3936  46169

Coefficients:
                        Estimate Std. Error t value Pr(>|t|)
(Intercept)           -35222.037   5749.350  -6.126 1.06e-08 ***
Ad_Spend                  48.888      5.914   8.267 1.64e-13 ***
Product_Quality_Score   5030.115    784.281   6.414 2.60e-09 ***
Website_Visitors           7.791      3.944   1.975   0.0504 .
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 10510 on 126 degrees of freedom
Multiple R-squared:  0.5849,    Adjusted R-squared:  0.575
F-statistic: 59.17 on 3 and 126 DF,  p-value: < 2.2e-16
Οι βαθμοί ελευθερίας του F-test (3 και 126 στο αποτέλεσμα) αντιστοιχούν στον αριθμό των προβλεπτικών μεταβλητών (\(k = 3\)) και στους βαθμούς ελευθερίας των καταλοίπων (\(n - k - 1 = 126\)) αντίστοιχα. Το σχετικό p-value προκύπτει από την κατανομή F με αυτούς τους βαθμούς ελευθερίας.
Από την οπτική του ελέγχου υποθέσεων, το F-test ελέγχει τη μηδενική υπόθεση ότι όλοι οι συντελεστές κλίσης είναι ίσοι με μηδέν:
\[H_0: \beta_1 = \beta_2 = \beta_3 = 0\]
έναντι της εναλλακτικής υπόθεσης ότι τουλάχιστον ένας από αυτούς είναι διάφορος του μηδενός.
Αυτός ο έλεγχος δεν περιλαμβάνει τον σταθερό όρο, επειδή τον εκτιμούμε πάντα από προεπιλογή. Ονομάζεται F-test συνολικής σημαντικότητας (F-test of overall significance), επειδή ελέγχει αν το μοντέλο, στο σύνολό του, εξηγεί ένα στατιστικά σημαντικό μέρος της μεταβλητότητας της εξαρτημένης μεταβλητής.
Μπορούμε επίσης να εκφράσουμε το στατιστικό F συναρτήσει της τιμής του \(R^2\):
\[F = \frac{R^2 / k}{(1 - R^2) / (n - k - 1)}\]
Αυτή η μορφή δείχνει ότι καθώς αυξάνεται το \(R^2\), δηλαδή καθώς βελτιώνεται η προσαρμογή του μοντέλου, το στατιστικό F μεγαλώνει, αυξάνοντας την πιθανότητα να απορρίψουμε τη μηδενική υπόθεση. Με άλλα λόγια, ένα υψηλό στατιστικό F σημαίνει ότι το μοντέλο εξηγεί ένα ουσιαστικό μέρος της μεταβλητότητας του \(y\), κάτι που υποδηλώνει ότι οι προβλεπτικές μεταβλητές είναι από κοινού στατιστικά σημαντικές (τουλάχιστον ένας συντελεστής κλίσης είναι διάφορος του μηδενός).
Ωστόσο, το F-test μπορεί να χρησιμοποιηθεί για περισσότερα από τον έλεγχο της συνολικής σημαντικότητας ενός μοντέλου παλινδρόμησης. Είναι επίσης ένα ισχυρό εργαλείο για τη σύγκριση διαφορετικών μοντέλων γραμμικής παλινδρόμησης, ιδιαίτερα όταν το ένα μοντέλο είναι ειδική περίπτωση (ή υποσύνολο) του άλλου. Αυτό συμβαίνει όταν το ένα μοντέλο περιλαμβάνει λιγότερες προβλεπτικές μεταβλητές από το άλλο.
Για παράδειγμα, ας θεωρήσουμε τα εξής δύο μοντέλα παλινδρόμησης:
Εδώ, το πρώτο μοντέλο είναι μια απλοποιημένη εκδοχή του δεύτερου—πρόκειται για εμφωλευμένα μοντέλα (nested models), αφού το περιορισμένο μοντέλο προκύπτει αν επιβάλουμε περιορισμούς στις παραμέτρους του μη περιορισμένου μοντέλου. Περιλαμβάνει μόνο μία προβλεπτική μεταβλητή (Ad_Spend) αντί για τρεις. Γι’ αυτό ονομάζεται περιορισμένο μοντέλο (restricted model), ενώ το δεύτερο, πιο ευέλικτο μοντέλο είναι το μη περιορισμένο μοντέλο (unrestricted model), το οποίο περιλαμβάνει επιπλέον τα Product_Quality_Score και Website_Visitors.
Το F-test μας επιτρέπει να ελέγξουμε αν αυτές οι δύο επιπλέον μεταβλητές βελτιώνουν από κοινού το μοντέλο. Με άλλα λόγια, ελέγχουμε αν οι συντελεστές τους (\(\beta_2\) και \(\beta_3\)) είναι και οι δύο ίσοι με μηδέν.
Και τα δύο μοντέλα εξηγούν ένα μέρος του συνολικού variance του Revenue. Το F-test συγκρίνει πόσο μειώνεται το άθροισμα τετραγώνων των καταλοίπων (RSS) όταν περνάμε από το περιορισμένο στο μη περιορισμένο μοντέλο. Αν η μείωση είναι αρκετά μεγάλη σε σχέση με την πρόσθετη πολυπλοκότητα, η βελτίωση θεωρείται στατιστικά σημαντική. Αυτός ο κοινός έλεγχος είναι χρήσιμος επειδή, ακόμη και αν τα μεμονωμένα t-tests για τα \(\beta_2\) και \(\beta_3\) δεν είναι σημαντικά, το F-test μπορεί να δείξει ότι οι μεταβλητές είναι από κοινού σημαντικές.
\(\text{RSS}_{R}\): Το άθροισμα τετραγώνων των καταλοίπων του περιορισμένου μοντέλου
\(\text{RSS}_{UR}\): Το άθροισμα τετραγώνων των καταλοίπων του μη περιορισμένου μοντέλου
\(q\): Ο αριθμός των περιορισμών (δηλαδή ο αριθμός των επιπλέον μεταβλητών που ελέγχονται από κοινού)
\(k\): Ο αριθμός των προβλεπτικών μεταβλητών στο μη περιορισμένο μοντέλο
\(n\): Το μέγεθος του δείγματος
Αυτός ο έλεγχος είναι επίσης γνωστός ως κοινός έλεγχος υποθέσεων (joint hypothesis test), επειδή ελέγχει πολλούς συντελεστές ταυτόχρονα. Αν το p-value που προκύπτει είναι μικρότερο από το επιλεγμένο επίπεδο σημαντικότητας (π.χ. 0.05), συμπεραίνουμε ότι οι επιπλέον μεταβλητές είναι από κοινού στατιστικά σημαντικές (jointly statistically significant), δηλαδή ότι συμβάλλουν ουσιαστικά στο μοντέλο. Διαφορετικά, είναι από κοινού στατιστικά μη σημαντικές.
Γιατί από κοινού σημαντικότητα;
Ίσως αναρωτηθείτε: Γιατί να μην ελέγξουμε απλώς τις μεμονωμένες τιμές t των επιπλέον μεταβλητών στο μη περιορισμένο μοντέλο; Η απάντηση είναι ότι τα μεμονωμένα t-tests αξιολογούν κάθε συντελεστή ξεχωριστά, κρατώντας όλους τους άλλους σταθερούς. Όταν όμως οι προβλεπτικές μεταβλητές συσχετίζονται, τα t-tests μπορεί να μην εντοπίσουν κοινές επιδράσεις. Στην πραγματικότητα, είναι αρκετά συνηθισμένο κανένα από τα μεμονωμένα t-tests να μη δείχνει σημαντικότητα, ενώ οι μεταβλητές είναι από κοινού σημαντικές όταν ελέγχονται μαζί. Αυτό είναι ιδιαίτερα σημαντικό όταν προσθέτουμε ένα σύνολο σχετικών μεταξύ τους μεταβλητών. Σε τέτοιες περιπτώσεις, το F-test προσφέρει μια πιο ολοκληρωμένη εικόνα για το αν η ομάδα των μεταβλητών, στο σύνολό της, βελτιώνει το μοντέλο.
Τακτοποιημένες συνόψεις μοντέλων και έλεγχος υποθέσεων στην R
Όπως συζητήσαμε προηγουμένως, όταν προσαρμόζουμε ένα γραμμικό μοντέλο με τη lm(), η R υπολογίζει αυτόματα μια σειρά χρήσιμων στατιστικών. Για να εξαγάγουμε αυτή την πληροφορία, μπορούμε να χρησιμοποιήσουμε το σύμβολο του δολαρίου ($), τη συνάρτηση summary() ή ακόμη και άλλες συναρτήσεις που εφαρμόζονται εύκολα, όπως οι coef() ή residuals().
Υπάρχει, ωστόσο, ένας πιο δομημένος και αποτελεσματικός τρόπος να εξαγάγουμε και να οργανώσουμε τα αποτελέσματα ενός μοντέλου. Το πακέτο broom, που δημιουργήθηκε από τον David Robinson, προσφέρει έναν βολικό και τακτοποιημένο τρόπο να εξαγάγουμε και να δουλέψουμε με τα αποτελέσματα των μοντέλων. Περιλαμβάνει τρεις βασικές συναρτήσεις:
tidy(): Αυτή η συνάρτηση εξάγει στατιστικά στο επίπεδο των συντελεστών, όπως τις εκτιμήσεις, τα standard errors, τις τιμές t και τα p-values, και τα επιστρέφει ως ένα καθαρό data frame. Αυτό διευκολύνει την προβολή, τον χειρισμό και την οπτικοποίηση των αποτελεσμάτων της παλινδρόμησης. Για να συμπεριλάβουμε επίσης διαστήματα εμπιστοσύνης για τους συντελεστές, ορίζουμε απλώς conf.int = TRUE και καθορίζουμε το επιθυμητό επίπεδο εμπιστοσύνης με το όρισμα conf.level.
# Βιβλιοθήκεςlibrary(broom)# Εφαρμογή της συνάρτησης tidy()tidy(lm_model, conf.int =TRUE, conf.level =0.95)
augment(): Αυτή η συνάρτηση προσθέτει πληροφορία στο αρχικό σύνολο δεδομένων, όπως τις προσαρμοσμένες τιμές (.fitted), τα κατάλοιπα (.resid) και το leverage. Ουσιαστικά συνδυάζει τα αρχικά δεδομένα με διαγνωστικά του μοντέλου, επιτρέποντας τη γρήγορη εξέταση του πόσο καλά προσαρμόζεται το μοντέλο σε κάθε παρατήρηση.
# Εφαρμογή της συνάρτησης augment()augment(lm_model, data = eshop_revenues)
glance(): Αυτή η συνάρτηση επιστρέφει μια σύνοψη μιας γραμμής με στατιστικά στο επίπεδο του μοντέλου, όπως το R-squared, το adjusted R-squared, το sigma και το στατιστικό F, καθώς και άλλα μέτρα που δεν έχουμε συζητήσει, όπως το AIC και το BIC. Είναι χρήσιμη όταν συγκρίνουμε πολλά μοντέλα ή όταν θέλουμε μια συνοπτική εικόνα των στατιστικών προσαρμογής.
# Εφαρμογή της συνάρτησης glance()glance(lm_model)
Ενώ τα t-tests της lm() (ή της tidy()) ελέγχουν έναν συντελεστή τη φορά, συχνά θέλουμε να ελέγξουμε πολλούς συντελεστές ταυτόχρονα. Εδώ γίνεται χρήσιμη η συνάρτηση linearHypothesis() του πακέτου car. Μας επιτρέπει να κάνουμε κοινούς ελέγχους υποθέσεων (F-tests) ή γενικότερους γραμμικούς περιορισμούς στους συντελεστές. Η συνάρτηση απαιτεί το object του μοντέλου (συνήθως δημιουργημένο με τη lm()) και ένα αλφαριθμητικό (ή vector αλφαριθμητικών) που ορίζει τις υποθέσεις, χρησιμοποιώντας τα ονόματα των μεταβλητών ακριβώς όπως εμφανίζονται στο μοντέλο.
Για παράδειγμα, ας υποθέσουμε ότι θέλουμε να ελέγξουμε αν ο συντελεστής του Ad_Spend είναι ίσος με 50:
Linear hypothesis test:
Ad_Spend = 50

Model 1: restricted model
Model 2: Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors

  Res.Df        RSS Df Sum of Sq      F Pr(>F)
1    127 1.3929e+10
2    126 1.3925e+10  1   3908792 0.0354 0.8511
Ακόμη πιο σημαντικό, μπορούμε να ελέγξουμε πολλούς περιορισμούς ταυτόχρονα, για παράδειγμα αν δύο ή περισσότεροι συντελεστές είναι από κοινού ίσοι με μηδέν:
Linear hypothesis test:
Product_Quality_Score = 0
Website_Visitors = 0

Model 1: restricted model
Model 2: Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors

  Res.Df        RSS Df  Sum of Sq      F    Pr(>F)
1    128 2.0023e+10
2    126 1.3925e+10  2 6098082321 27.589 1.155e-10 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Έτσι προκύπτουν ένα στατιστικό F και ένα p-value για την κοινή υπόθεση ότι και οι δύο συντελεστές είναι μηδέν. Αυτό είναι ιδιαίτερα χρήσιμο όταν αξιολογούμε αν μια ομάδα προβλεπτικών μεταβλητών προσθέτει σημαντική ερμηνευτική ισχύ στο μοντέλο.
Στην πραγματικότητα, αν χρησιμοποιήσουμε τη linearHypothesis() για να ελέγξουμε αν όλοι οι συντελεστές (εκτός του σταθερού όρου) είναι ίσοι με μηδέν, ουσιαστικά αναπαράγουμε το F-test συνολικής σημαντικότητας που εμφανίζεται στο κάτω μέρος του αποτελέσματος της summary(lm_model):
Linear hypothesis test:
Ad_Spend = 0
Product_Quality_Score = 0
Website_Visitors = 0

Model 1: restricted model
Model 2: Revenue ~ Ad_Spend + Product_Quality_Score + Website_Visitors

  Res.Df        RSS Df  Sum of Sq     F    Pr(>F)
1    129 3.3542e+10
2    126 1.3925e+10  3 1.9617e+10 59.17 < 2.2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Το στατιστικό F που προκύπτει είναι 59.17, το ίδιο που πήραμε νωρίτερα με τη συνάρτηση summary().
Ετεροσκεδαστικότητα
Μέχρι αυτό το σημείο, συζητήσαμε τις υποθέσεις που είναι απαραίτητες για να πάρουμε εκτιμήσεις BLUE (βέλτιστος γραμμικός αμερόληπτος εκτιμητής), μία από τις οποίες είναι η ομοσκεδαστικότητα—η υπόθεση ότι το variance των σφαλμάτων παραμένει σταθερό σε όλες τις τιμές των ανεξάρτητων μεταβλητών. Αν αυτή η υπόθεση παραβιάζεται, έχουμε ετεροσκεδαστικότητα, που σημαίνει ότι το θεώρημα Gauss-Markov δεν ισχύει πλέον και οι εκτιμήσεις OLS, αν και εξακολουθούν να είναι αμερόληπτες, δεν είναι πλέον αποτελεσματικές (Wooldridge, 2020).
Όταν δουλεύουμε με μία ή ακόμη και δύο ανεξάρτητες μεταβλητές, ο εντοπισμός της ετεροσκεδαστικότητας είναι συχνά εφικτός με οπτικά εργαλεία. Ωστόσο, όταν το μοντέλο περιλαμβάνει πολλές προβλεπτικές μεταβλητές, η οπτική επιθεώρηση γίνεται πιο δύσκολη και οι τυπικοί στατιστικοί έλεγχοι γίνονται πιο χρήσιμοι.
Ένας συνηθισμένος έλεγχος είναι η εκδοχή F (F-version) του ελέγχου Breusch-Pagan (Breusch-Pagan test). Η λογική πίσω από αυτόν τον έλεγχο είναι απλή. Αν ισχύει η υπόθεση της ομοσκεδαστικότητας, τότε το variance των όρων σφάλματος δεν θα πρέπει να μεταβάλλεται συστηματικά με τις τιμές των ανεξάρτητων μεταβλητών. Με άλλα λόγια, δεν θα πρέπει να υπάρχει συνάφεια μεταξύ των ανεξάρτητων μεταβλητών και των τετραγωνισμένων καταλοίπων του μοντέλου.
Μαθηματικά, η ομοσκεδαστικότητα σημαίνει ότι το variance των όρων σφάλματος είναι σταθερό σε όλες τις παρατηρήσεις, κάτι που συχνά γράφεται ως \(Var(u_i) = \sigma^2\) για κάθε \(i\). Όταν αυτή η υπόθεση παραβιάζεται, το variance δεν είναι πλέον σταθερό αλλά διαφέρει από παρατήρηση σε παρατήρηση. Σε αυτή την περίπτωση, γράφουμε \(Var(u_i) = \sigma^2_i\), δείχνοντας ότι κάθε όρος σφάλματος έχει το δικό του variance. Αυτή ακριβώς την ανομοιογένεια στα variances των σφαλμάτων είναι σχεδιασμένος να εντοπίζει ο έλεγχος Breusch-Pagan.
Για να ελέγξουμε αν ισχύει η υπόθεση της ομοσκεδαστικότητας, παίρνουμε πρώτα τα κατάλοιπα του αρχικού μοντέλου παλινδρόμησης και τα υψώνουμε στο τετράγωνο. Στη συνέχεια, εκτελούμε μια νέα παλινδρόμηση όπου τα τετραγωνισμένα κατάλοιπα είναι η εξαρτημένη μεταβλητή και οι αρχικές ανεξάρτητες μεταβλητές παραμένουν ως προβλεπτικές. Αν ισχύει η ομοσκεδαστικότητα, καμία από τις προβλεπτικές μεταβλητές δεν θα πρέπει να εξηγεί σημαντικά τη μεταβλητότητα των τετραγωνισμένων καταλοίπων, και το στατιστικό F αυτής της πρόσθετης παλινδρόμησης θα πρέπει να είναι χαμηλό, με αποτέλεσμα ένα υψηλό p-value. Αυτό θα μας οδηγούσε στη μη απόρριψη της μηδενικής υπόθεσης, η οποία είναι η υπόθεση της ομοσκεδαστικότητας.
Δείτε πώς μπορούμε να το υλοποιήσουμε στην R:
# Εξαγωγή των καταλοίπων και ύψωσή τους στο τετράγωνοu <- lm_model %>%residuals()u_squared <- u^2# Βοηθητική παλινδρόμηση: τετραγωνισμένα κατάλοιπα στις αρχικές προβλεπτικές μεταβλητέςlm(u_squared ~ Ad_Spend + Product_Quality_Score + Website_Visitors,data = eshop_revenues) %>%summary()
Call:
lm(formula = u_squared ~ Ad_Spend + Product_Quality_Score + Website_Visitors,
    data = eshop_revenues)

Residuals:
       Min         1Q     Median         3Q        Max
-655800004  -92496960   -6464980   43662514 1669907169

Coefficients:
                        Estimate Std. Error t value Pr(>|t|)
(Intercept)           -198233593  118194894  -1.677    0.096 .
Ad_Spend                  873170     121577   7.182 5.28e-11 ***
Product_Quality_Score    4125727   16123211   0.256    0.798
Website_Visitors           98372      81089   1.213    0.227
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 216100000 on 126 degrees of freedom
Multiple R-squared:  0.3834,    Adjusted R-squared:  0.3687
F-statistic: 26.12 on 3 and 126 DF,  p-value: 3.317e-13
Σε αυτό το αποτέλεσμα, μας ενδιαφέρει κυρίως το p-value του στατιστικού F, το οποίο ελέγχει την από κοινού σημαντικότητα των ανεξάρτητων μεταβλητών στην εξήγηση των τετραγωνισμένων καταλοίπων. Αν αυτό το p-value είναι μικρό (π.χ. κάτω από 0.05 ή 0.01), απορρίπτουμε τη μηδενική υπόθεση του σταθερού variance, κάτι που δείχνει ότι υπάρχει ετεροσκεδαστικότητα.
Στο παραπάνω παράδειγμα, το p-value του στατιστικού F είναι πολύ χαμηλό, ακόμη και σε επίπεδο σημαντικότητας 1%. Αυτό υποδηλώνει την παρουσία ετεροσκεδαστικότητας. Επιπλέον, μπορούμε να εξετάσουμε τους μεμονωμένους συντελεστές της βοηθητικής παλινδρόμησης (auxiliary regression). Αν μία ή περισσότερες μεταβλητές (π.χ. το Ad_Spend) είναι στατιστικά σημαντικές, μπορεί να συμβάλλουν περισσότερο στο άνισο variance των καταλοίπων. Αυτό μπορεί να προσφέρει χρήσιμη διαγνωστική πληροφόρηση, αν και το αποτέλεσμα του F-test παραμένει η κύρια ένδειξη ετεροσκεδαστικότητας.
Συνοψίζοντας, ο έλεγχος Breusch-Pagan προσφέρει μια τυπική και εύκολα ερμηνεύσιμη μέθοδο για τον έλεγχο της υπόθεσης της ομοσκεδαστικότητας, η οποία είναι καθοριστική για την εγκυρότητα των standard errors, των διαστημάτων εμπιστοσύνης και των ελέγχων υποθέσεων στα μοντέλα γραμμικής παλινδρόμησης.
Χρήση εξωτερικών vectors στη lm()
Στο τελευταίο κομμάτι κώδικα, μπορέσαμε να χρησιμοποιήσουμε το vector u_squared στον τύπο της παλινδρόμησης, παρόλο που δεν είναι στήλη του data frame eshop_revenues. Αυτό δουλεύει επειδή, όταν μια μεταβλητή δεν βρίσκεται στο data frame, η lm() την αναζητά στο περιβάλλον όπου δημιουργήθηκε ο τύπος (εδώ, στο καθολικό περιβάλλον, global environment). Αφού το u_squared υπάρχει ως ξεχωριστό vector στη μνήμη (και έχει το ίδιο μήκος με τις γραμμές του eshop_revenues), η R μπορεί να το αντιστοιχίσει σωστά με τις αντίστοιχες παρατηρήσεις. Είναι σημαντικό να θυμόμαστε ότι αυτό δουλεύει μόνο αν το vector έχει το ίδιο μήκος με τον αριθμό των παρατηρήσεων του data frame και είναι στην ίδια σειρά. Μια εναλλακτική προσέγγιση θα ήταν να αποθηκεύσουμε τα τετραγωνισμένα κατάλοιπα σε μια ξεχωριστή στήλη του object eshop_revenues και στη συνέχεια να χρησιμοποιήσουμε τη συνάρτηση lm().
Έλεγχος Breusch-Pagan: εκδοχές LM και F
Νωρίτερα, παρουσιάσαμε το Breusch-Pagan F-test για τον εντοπισμό της ετεροσκεδαστικότητας. Για την ακρίβεια, αυτή είναι μία εκδοχή του ελέγχου Breusch-Pagan—συγκεκριμένα, η εκδοχή F. Υπάρχει επίσης μια εκδοχή πολλαπλασιαστή Lagrange (Lagrange Multiplier, LM), η οποία διαφέρει κυρίως στο στατιστικό ελέγχου και στην κατανομή του: η εκδοχή F χρησιμοποιεί το στατιστικό F της βοηθητικής παλινδρόμησης και μια κατανομή F, ενώ η εκδοχή LM χρησιμοποιεί το στατιστικό \(n \cdot R^2\) (όπου το \(R^2\) προέρχεται από τη βοηθητική παλινδρόμηση) και μια κατανομή χι-τετράγωνο με \(k\) βαθμούς ελευθερίας.
Και οι δύο εκδοχές λειτουργούν με τον ίδιο τρόπο: κάνουν παλινδρόμηση των τετραγωνισμένων καταλοίπων στις ανεξάρτητες μεταβλητές, για να ελέγξουν αν το variance των σφαλμάτων εξαρτάται από αυτές. Και οι δύο εκδοχές τεκμηριώνονται σε μεγάλα δείγματα, και η εκδοχή LM είναι αυτή που αναφέρουν πολλές συναρτήσεις λογισμικού (για παράδειγμα, η bptest() του package lmtest). Ένα σημαντικό αποτέλεσμα σε οποιονδήποτε από τους δύο ελέγχους δείχνει ετεροσκεδαστικότητα, που σημαίνει ότι παραβιάζεται η υπόθεση της ομοσκεδαστικότητας: οι εκτιμήσεις των συντελεστών παραμένουν αμερόληπτες, αλλά δεν είναι πλέον αποτελεσματικές, και τα συνηθισμένα standard errors δεν είναι έγκυρα.
Στα περισσότερα σύνολα δεδομένων, οι δύο εκδοχές οδηγούν στο ίδιο συμπέρασμα, με διαφορές να εμφανίζονται κυρίως σε πολύ μικρά δείγματα ή σε ασυνήθιστα δεδομένα. Επομένως, είτε χρησιμοποιήσουμε την εκδοχή F είτε την εκδοχή LM (χι-τετράγωνο), το συμπέρασμα για την ετεροσκεδαστικότητα είναι συνήθως το ίδιο.
Αν εντοπίσουμε ετεροσκεδαστικότητα, γνωρίζουμε ότι η συμπερασματολογία μας μπορεί να είναι λανθασμένη και ότι οι συντελεστές που εκτιμήθηκαν με τη μέθοδο των ελαχίστων τετραγώνων (OLS) δεν είναι πλέον BLUE (βέλτιστοι γραμμικοί αμερόληπτοι εκτιμητές). Παρόλο που υπάρχουν εναλλακτικές μέθοδοι εκτίμησης, μια πιο συνηθισμένη και πρακτική προσέγγιση είναι να προσαρμόσουμε τα standard errors ώστε να λαμβάνουν υπόψη την ετεροσκεδαστικότητα.
Η ετεροσκεδαστικότητα σημαίνει ότι το variance των όρων σφάλματος μεταβάλλεται με τις τιμές των ανεξάρτητων μεταβλητών, παραβιάζοντας την υπόθεση του σταθερού variance. Γι’ αυτό, ο συνηθισμένος τύπος για τον υπολογισμό του variance των εκτιμήσεων των συντελεστών δεν είναι πλέον έγκυρος. Αντί γι’ αυτόν, χρησιμοποιούμε ανθεκτικά standard errors (robust standard errors), τα οποία δίνουν συνεπείς εκτιμήσεις των variances των συντελεστών ακόμη και όταν υπάρχει ετεροσκεδαστικότητα.
Αυτά τα ανθεκτικά standard errors στην ετεροσκεδαστικότητα (heteroskedasticity-robust standard errors) μας επιτρέπουν να εκτελούμε έγκυρους ελέγχους υποθέσεων και να κατασκευάζουμε αξιόπιστα διαστήματα εμπιστοσύνης χωρίς να αλλάζουν οι ίδιοι οι εκτιμημένοι συντελεστές. Αυτή η προσαρμογή χρησιμοποιείται ευρέως στην εφαρμοσμένη ανάλυση παλινδρόμησης, επειδή είναι εύκολη στην υλοποίηση και δεν απαιτεί αλλαγή του μοντέλου. Σημαντικό είναι ότι δεν απαιτεί τα σφάλματα να κατανέμονται κανονικά, καθώς βασίζεται σε αποτελέσματα μεγάλων δειγμάτων (ασυμπτωτικά αποτελέσματα). Ο λόγος είναι ότι, ακόμη και όταν οι όροι σφάλματος δεν είναι κανονικοί και μπορεί να έχουν μη σταθερό variance, ο εκτιμητής OLS κατανέμεται κατά προσέγγιση κανονικά σε μεγάλα δείγματα χάρη στο κεντρικό οριακό θεώρημα. Τα ανθεκτικά standard errors διορθώνουν στη συνέχεια το εκτιμημένο variance των συντελεστών, ώστε η συμπερασματολογία να παραμένει έγκυρη υπό ετεροσκεδαστικότητα.
Στην R, μπορούμε να υπολογίσουμε εύκολα standard errors ανθεκτικά στην ετεροσκεδαστικότητα με τα πακέτα sandwich και lmtest. Αυτά τα πακέτα συνεργάζονται και προσφέρουν έναν ευέλικτο και βολικό τρόπο να διορθώσουμε την ετεροσκεδαστικότητα σε γραμμικά μοντέλα.
Η vcovHC() του πακέτου sandwich υπολογίζει έναν πίνακα variance-covariance συνεπή ως προς την ετεροσκεδαστικότητα (ανθεκτικό) για τους συντελεστές ενός γραμμικού μοντέλου. Το όρισμα type = "HC1" ορίζει την εκδοχή του ανθεκτικού εκτιμητή. Παρόλο που υπάρχουν και άλλοι τύποι, όπως οι "HC0", "HC2" ή "HC3", καθένας με ελαφρώς διαφορετικές προσαρμογές, ο "HC1" χρησιμοποιείται συνήθως στην πράξη.
Η coeftest() του πακέτου lmtest εκτελεί ελέγχους υποθέσεων (π.χ. t-tests) στους συντελεστές ενός μοντέλου. Από προεπιλογή, χρησιμοποιεί τον συνήθη πίνακα variance-covariance του OLS, αλλά μπορούμε να τον αντικαταστήσουμε δίνοντας έναν ανθεκτικό πίνακα, όπως αυτόν της vcovHC(), μέσω του ορίσματος vcov.
Δείτε πώς συνεργάζονται στην πράξη:
# Βιβλιοθήκεςlibrary(sandwich)library(lmtest)# Υπολογισμός των ανθεκτικών standard errorsrobust_se <-vcovHC(lm_model, type ="HC1")# Εκτέλεση ελέγχων των συντελεστών με ανθεκτικά standard errorscoeftest(lm_model, vcov = robust_se)
Παρατηρούμε ότι οι εκτιμημένοι συντελεστές παραμένουν ίδιοι, αλλά τα standard errors έχουν αλλάξει—με αποτέλεσμα διαφορετικές τιμές t και p-values. Για παράδειγμα, ο συντελεστής του Website_Visitors είναι πλέον στατιστικά σημαντικός σε επίπεδο 5%. Αυτό δείχνει πώς η προσαρμογή για την ετεροσκεδαστικότητα μπορεί να αλλάξει τη συμπερασματολογία μας και να οδηγήσει σε διαφορετικά συμπεράσματα για το ποιες προβλεπτικές μεταβλητές είναι σημαντικές.
Ένα συνηθισμένο ερώτημα είναι αν πρέπει να χρησιμοποιούμε πάντα ανθεκτικά standard errors στην ετεροσκεδαστικότητα ως προφύλαξη. Πρόκειται για εύλογο προβληματισμό, και πράγματι, πολλές ακαδημαϊκές εργασίες αναφέρουν και τα standard errors υπό ομοσκεδαστικότητα και τα ανθεκτικά standard errors στην ετεροσκεδαστικότητα. Ωστόσο, αν ισχύει η ομοσκεδαστικότητα, τα συνηθισμένα standard errors είναι έγκυρα—και, με κανονικά σφάλματα, ακριβώς έγκυρα ακόμη και σε μικρά δείγματα—ενώ τα ανθεκτικά standard errors τεκμηριώνονται μόνο σε μεγάλα δείγματα. Σε μικρά δείγματα, τα ανθεκτικά standard errors μπορεί να είναι ανακριβή, και τα αντίστοιχα στατιστικά t μπορεί να μην ακολουθούν ικανοποιητικά την κατανομή t, κάτι που μπορεί να οδηγήσει σε παραπλανητική συμπερασματολογία.
Ανακεφαλαίωση
Σε αυτό το κεφάλαιο, εξετάσαμε πώς αξιολογούμε και ερμηνεύουμε τα μοντέλα γραμμικής παλινδρόμησης πέρα από την εκτίμηση των συντελεστών. Πιο συγκεκριμένα, καλύψαμε τον έλεγχο υποθέσεων στο πλαίσιο της γραμμικής παλινδρόμησης με t-tests και F-tests.
Επιπλέον, παρουσιάσαμε το πακέτο broom, το οποίο προσφέρει έναν καθαρότερο και πιο προσιτό τρόπο να εξαγάγουμε και να οργανώσουμε τα αποτελέσματα ενός μοντέλου με συναρτήσεις όπως οι tidy(), augment() και glance(). Δείξαμε επίσης τη χρήση της συνάρτησης linearHypothesis() του πακέτου car, η οποία επιτρέπει τον έλεγχο γενικών γραμμικών περιορισμών σε πολλούς συντελεστές, κάνοντάς τη πολύτιμο εργαλείο για κοινούς ελέγχους υποθέσεων.
Το κεφάλαιο ολοκληρώθηκε με μια εις βάθος εξέταση της ετεροσκεδαστικότητας—μιας παραβίασης της υπόθεσης του σταθερού variance που υπονομεύει τη συμπερασματολογία. Εξηγήσαμε πώς εντοπίζουμε την ετεροσκεδαστικότητα με τον έλεγχο Breusch-Pagan, τόσο στη μορφή του F-test όσο και ως έλεγχο πολλαπλασιαστή Lagrange. Τονίσαμε ότι, ενώ οι συντελεστές OLS παραμένουν αμερόληπτοι υπό ετεροσκεδαστικότητα, τα standard errors τους γίνονται μη συνεπή. Για να το αντιμετωπίσουμε, δείξαμε πώς υπολογίζουμε ανθεκτικά standard errors στην ετεροσκεδαστικότητα με τα πακέτα sandwich και lmtest της R. Τέλος, συζητήσαμε το πρακτικό ερώτημα αν πρέπει να χρησιμοποιούνται πάντα ανθεκτικά standard errors, σημειώνοντας ότι, ενώ προστατεύουν από την ετεροσκεδαστικότητα, μπορεί να είναι αναξιόπιστα σε μικρά δείγματα όταν ισχύουν οι τυπικές υποθέσεις—γι’ αυτό πολλές εργασίες αναφέρουν και τα δύο.